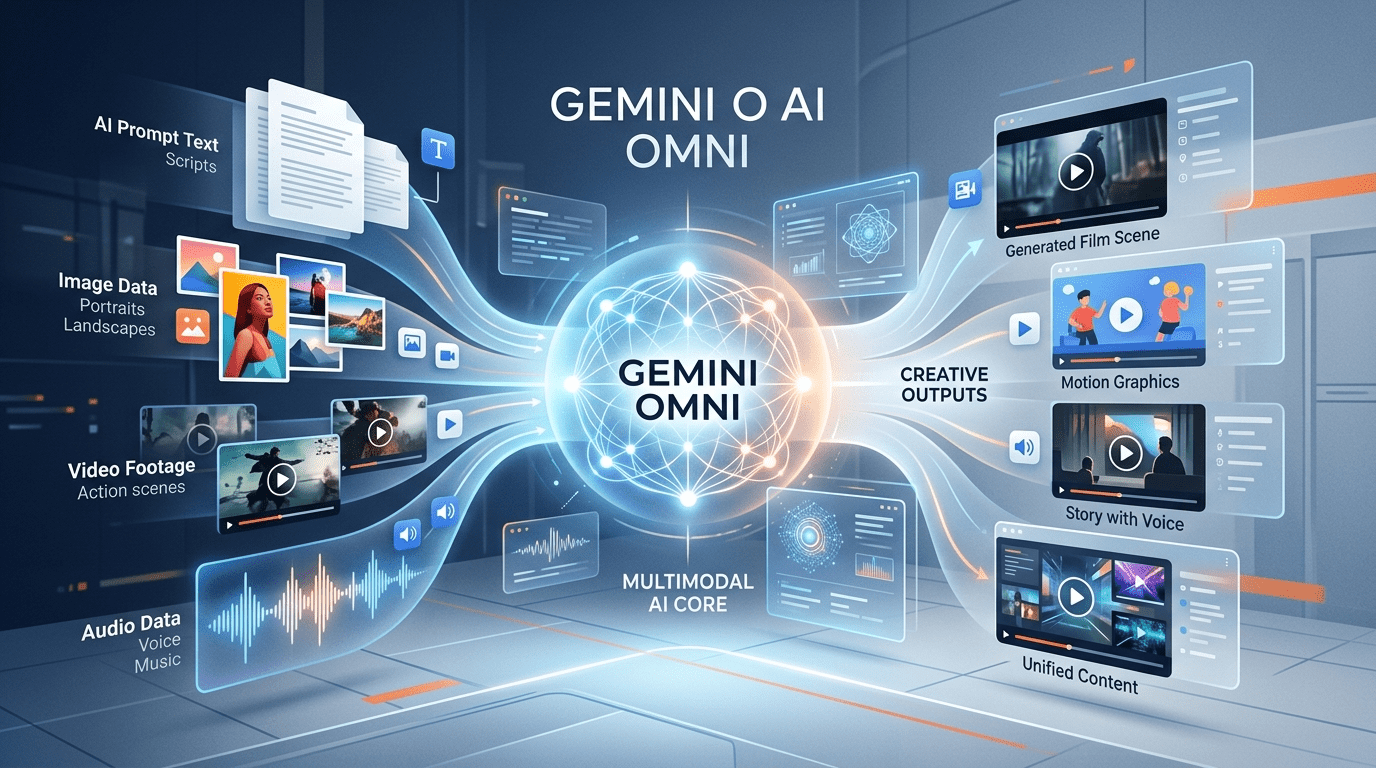
구글이 최근 개발자 행사에서 어떤 형태의 자료든 받아서 원하는 결과물을 만들어내는 새로운 인공지능 기술을 공개했습니다.
이번에 선보인 ‘제미나이 옴니’는 글과 사진, 동영상, 소리를 모두 이해하고 처리할 수 있는 차세대 멀티모달 AI입니다. 지난해 이미지 제작 기능을 선보인 이후, 오래된 사진 복원이나 스케치 기반 디자인 등 여러 분야에서 활용되어 왔으며, 이제는 영상 제작 영역까지 범위를 넓혔습니다.
핵심 특징은 대화하듯 명령어를 입력하면 영상을 수정할 수 있다는 점입니다. 이전 작업 내용을 유지하면서도 추가 편집이 가능하며, 등장인물의 모습이나 장면의 흐름, 물리 법칙까지 자연스럽게 이어집니다.
예를 들어 촬영한 영상에서 특정 물건만 바꾸거나, 배경 전체를 다른 세계로 변환할 수 있습니다. 영상 속 동작을 수정하거나 새로운 사람과 사물을 추가하는 것도 가능합니다. 단순한 필터 적용을 넘어서, 기존 영상을 완전히 새로운 이야기로 재구성할 수 있는 수준입니다.
여러 번 수정하더라도 원본 장면의 맥락은 그대로 유지됩니다. 환경, 카메라 각도, 스타일, 세부 요소를 반복해서 바꾸면서도 전체적인 흐름을 잃지 않고 작업할 수 있습니다.
구글 측은 이 시스템이 단순히 사실적인 장면을 만드는 데 그치지 않고, 다음에 무엇이 일어나야 할지까지 추론한다고 설명했습니다. 물리학, 역사, 과학, 문화적 배경에 대한 지식을 활용해 자연스럽고 의미 있는 스토리를 구현한다는 것입니다.
물리 법칙에 대한 이해 능력도 향상되었습니다. 중력, 운동 에너지, 유체 역학 등 실제 세계의 물리 원리를 바탕으로 더욱 현실감 있는 장면을 생성합니다.
복잡한 개념을 시각적으로 설명하는 기능도 제공됩니다. 짧은 문장만으로도 설명 영상을 만들어 어려운 아이디어를 쉽게 표현할 수 있습니다. 단순히 패턴을 맞추는 것이 아니라, 언어와 이미지, 의미를 연결해 창의적으로 표현한다고 합니다.
입력 방식도 다양해졌습니다. 사진, 글, 영상, 음성을 참고 자료로 사용할 수 있으며, 옴니는 이를 하나의 통일된 결과물로 합칩니다. 음성 입력은 초기에는 사용자 목소리 참조 기능만 지원되지만, 향후 다른 오디오 입력 방식도 추가될 예정입니다.
사용자가 가진 캐릭터 이미지나 장면 사진, 스케치 등을 활용해 원하는 스타일과 움직임, 효과를 영상에 반영할 수 있습니다. 자연어 설명만으로도 특정 시각 스타일을 지정할 수 있으며, 여러 입력 자료를 조합해 통일감 있는 영상을 생성합니다.
‘아바타’ 기능을 활용하면 자신의 목소리와 외모를 기반으로 한 디지털 아바타 영상을 만들 수 있습니다. 다만 음성 변경 및 대사 편집 기능은 오용 가능성을 고려해 현재 추가 테스트가 진행 중입니다.
제미나이 옴니 플래시는 전 세계 구글 AI 유료 구독자를 대상으로 제미나이 앱과 구글 플로우를 통해 제공되며, 유튜브 쇼츠와 유튜브 크리에이트 앱 사용자에게는 무료로 배포됩니다. 구글은 몇 주 내에 개발자와 기업 고객을 위한 API 형태의 서비스도 시작할 계획이라고 밝혔습니다.